압축 프로그램을 열면 압축 수준을 고르는 칸이 있습니다. 보통 기본값에 맞춰져 있고, 그 옆에 최고 압축이라는 선택지가 놓여 있습니다.
이 손잡이는 용량과 시간을 맞바꾸는 장치입니다. 그래서 어디까지 올릴 값어치가 있는지는 숫자로 봐야 알 수 있습니다. 성격이 다른 두 묶음을 레벨마다 다섯 번씩 압축해 용량과 시간을 함께 쟀습니다.
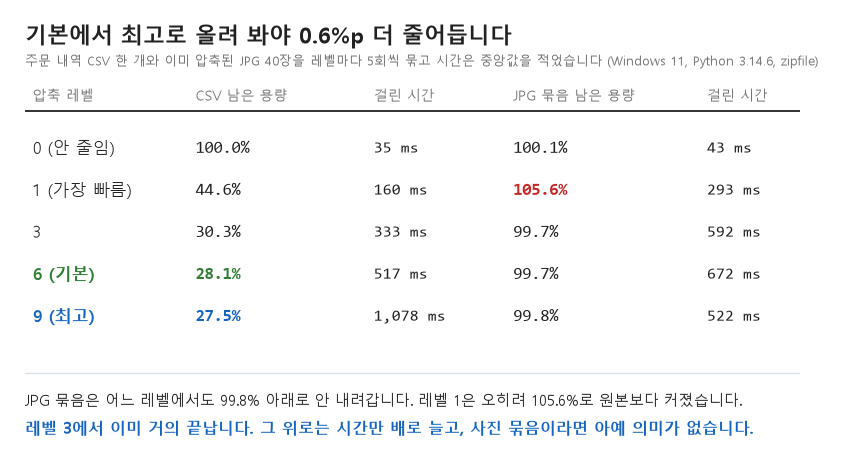
텍스트는 레벨 3에서 거의 끝납니다
먼저 잘 줄어드는 쪽입니다. 값이 조금씩 다른 주문 내역 12만 행을 CSV로 만들었습니다. 7,817,314바이트짜리 파일입니다.
| 압축 레벨 | 남은 용량 | 걸린 시간 | 앞 단계보다 |
|---|---|---|---|
| 1 (가장 빠름) | 44.6% | 158 ms | |
| 3 | 30.3% | 328 ms | 14.3%p 줄어듦 |
| 6 (기본) | 28.1% | 520 ms | 2.2%p 줄어듦 |
| 9 (최고) | 27.5% | 1,038 ms | 0.6%p 줄어듦 |
레벨 1에서 3으로 올릴 때는 14.3%p가 한 번에 빠집니다. 그런데 기본값인 6에서 최고인 9로 올리면 0.6%p가 더 줄고 시간은 두 배가 됩니다. 1,038밀리초를 써서 얻는 것이 48,574바이트입니다.
사진 묶음에서는 레벨을 올릴수록 손해입니다
같은 시험을 이미 압축된 파일로 한 번 더 했습니다. JPG 사진 40장, 합계 5,271,571바이트입니다. 결과가 전혀 다릅니다.
어느 레벨에서도 99.7% 아래로 내려가지 않았습니다. JPG는 만들어질 때 이미 압축을 거친 형식이라 ZIP이 더 짜낼 것이 남아 있지 않습니다. 눈에 띄는 것은 레벨 1입니다. 5,568,731바이트가 나와 원본보다 5.6% 커졌습니다. 압축이 안 되는 자료에 빠른 방식을 적용하면 오히려 관리용 정보만 덧붙는 경우가 생깁니다.
직접 재 보는 코드
내 파일이 어느 쪽인지는 두 레벨만 비교해 보면 바로 알 수 있습니다. 표준 라이브러리만 씁니다.
import os, time, zipfile

src = r"C:\경로\보낼파일.csv"
for level in (1, 6, 9):
    out = f"test_{level}.zip"
    t0 = time.perf_counter()
    with zipfile.ZipFile(out, "w", zipfile.ZIP_DEFLATED,
                         compresslevel=level) as zf:
        zf.write(src, os.path.basename(src))
    ms = (time.perf_counter() - t0) * 1000
    pct = os.path.getsize(out) / os.path.getsize(src) * 100
    print(f"레벨 {level}: {pct:.1f}%  {ms:.0f} ms")
레벨 1과 9의 결과가 5%p 안쪽으로 붙어 나온다면 그 자료는 더 짜낼 것이 없는 쪽입니다. 시간만 버리게 되니 낮은 쪽을 고르면 됩니다.
레벨이 실제로 바꾸는 것
ZIP 이 쓰는 압축 방식은 앞에 나왔던 것과 같은 조각이 뒤에 또 나오면, 그 내용을 그대로 적는 대신 앞자리를 가리키는 짧은 표시로 바꿔 넣습니다. 레벨은 그 조각을 얼마나 멀리까지 얼마나 끈질기게 찾아볼지를 정하는 값입니다.
낮은 레벨은 가까운 범위만 훑고 지나가고, 높은 레벨은 더 넓게 뒤져 더 긴 반복까지 찾아냅니다. 그래서 같은 문구가 자주 나오는 자료일수록 올린 만큼 값을 합니다. 반대로 찾을 반복이 애초에 없는 자료에서는 뒤지는 시간만 늘어납니다. 위 표의 두 묶음이 정확히 그 두 경우입니다.
그래서 어디에 맞출까
문서, 로그, CSV처럼 글자가 반복되는 자료라면 기본값이 무난하고 급할 때는 3도 충분합니다. 사진과 영상, 이미 만들어진 압축 파일을 묶는 일이라면 최고 압축은 시간만 씁니다. 형식을 바꿔 보는 쪽이 나은지 궁금하다면 ZIP과 7Z와 TAR.GZ를 같은 폴더로 비교한 결과가 참고가 되고, 파일 개수가 많아 줄지 않는 경우라면 개수 자체가 만드는 고정 비용 쪽이 원인일 수 있습니다.
같은 손잡이가 7Z 와 TAR.GZ 에도 달려 있습니다. 부르는 이름과 단계 수는 형식마다 다르지만, 올린 만큼 값을 하는지는 결국 넣는 자료가 정한다는 점은 똑같습니다.
위 용량과 시간은 윈도우 11에서 파이썬 3.14.6의 표준 라이브러리 zipfile로 레벨마다 다섯 번씩 압축해 얻은 값이고, 시간은 그 다섯 번의 중앙값입니다. 용량은 실행할 때마다 같았고 시간은 컴퓨터 사정에 따라 흔들립니다.
'압축' 카테고리의 다른 글
| 압축 파일 안의 문서 한 장만 고쳐야 할 때, 전부 풀지 않고 바꾸기 (0) | 2026.10.01 |
|---|---|
| 압축 파일 안에 뭐가 들었는지, 풀지 않고 확인하고 필요한 것만 꺼내기 (0) | 2026.09.30 |
| 사진과 동영상을 ZIP으로 묶으면 용량이 줄 거라는 생각, 실제로는 거의 그대로입니다 (0) | 2026.09.22 |
| 작은 파일이 수천 개인 폴더는 압축해도 왜 별로 안 줄어들까 (0) | 2026.09.17 |
| ZIP이 손상되었다고 뜰 때, 어디가 깨졌는지부터 확인하면 살릴 수 있습니다 (0) | 2026.08.30 |


