데이터를 내려받았더니 확장자가 .jsonl이거나, 메모장으로 열어 보니 줄마다 중괄호로 시작하는 객체가 따로따로 적혀 있어 당황하는 경우가 있습니다. 평소 보던 JSON처럼 맨 앞에 대괄호 [가 없고, 객체 사이를 쉼표로 잇지도 않아서 깨진 파일로 오해하기 쉽습니다.
이건 망가진 JSON이 아니라 JSON Lines라는 정상 형식입니다. NDJSON(Newline Delimited JSON)이라고도 부릅니다. 규칙은 단순합니다. 한 줄에 완결된 JSON 객체 하나를 넣고, 객체와 객체는 쉼표가 아니라 줄바꿈으로 구분합니다.
한 줄로 말하면
일반 JSON 배열은 데이터를 하나의 큰 덩어리 [ {...}, {...} ]로 묶습니다. JSON Lines는 그 묶음을 풀어 객체마다 한 줄씩 세워 둔 것입니다. 그래서 한 줄만 떼어 내도 그 자체로 완전한 JSON이 됩니다.
같은 데이터, 두 형태를 나란히 보면
회원 이벤트 기록 같은 표 형태 데이터를 두 방식으로 저장하면 생김새가 이렇게 갈립니다. 실제로 저장해 앞부분을 꺼내 본 모습입니다.
[JSON 배열] 한 덩어리, 객체 사이는 쉼표
[{"user_id": 1, "name": "박서연", "event": "purchase", "amount": 42659}, {"user_id": 2, ...

[JSON Lines / NDJSON] 한 줄에 객체 하나, 끝에 줄바꿈
{"user_id": 1, "name": "박서연", "event": "purchase", "amount": 42659}
{"user_id": 2, "name": "이민수", "event": "view", "amount": 6168}
{"user_id": 3, "name": "박도윤", "event": "login", "amount": 33255}
배열은 시작과 끝을 대괄호로 감싸고 객체를 쉼표로 잇기 때문에, 파일이 문법적으로 완성되려면 마지막 닫는 대괄호까지 다 있어야 합니다. 반면 NDJSON은 줄 하나하나가 독립적이라, 중간에서 잘려도 거기까지 읽은 줄은 멀쩡합니다.
그럼 NDJSON이 용량도 작을까, 직접 재 봤습니다
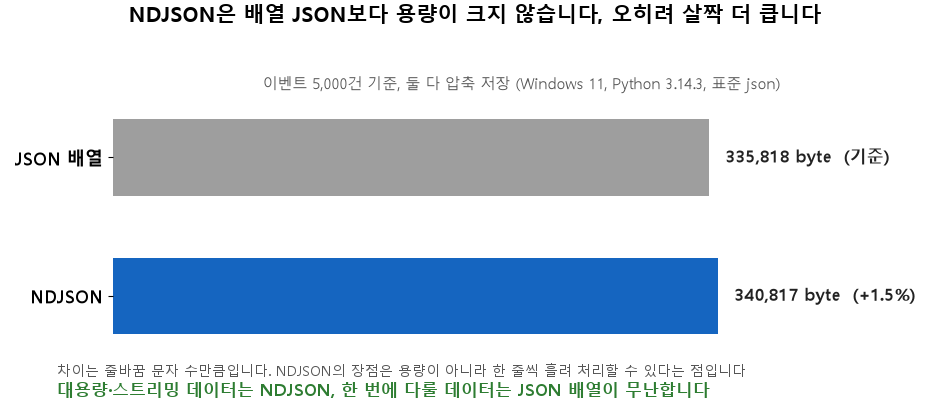
흔히 "한 줄씩이라 더 가볍다"고 짐작하지만 실측은 다릅니다. 회원 이벤트 5,000건을 같은 내용으로 두 방식에 저장해 바이트를 쟀습니다. 측정 환경은 윈도우 11, 파이썬 3.14.3, 표준 라이브러리 json, UTF-8입니다. 공정하게 둘 다 공백 없는 압축 저장(separators=(",",":"))으로 맞췄습니다.
| 저장 방식 | 용량 | 차이 |
|---|---|---|
| JSON 배열 (compact) | 335,818 byte | 기준 |
| NDJSON (compact) | 340,817 byte | +4,999 byte (약 1.5% 큼) |
예상과 달리 NDJSON이 아주 약간 더 큽니다. 이유는 구분 문자에 있습니다. 배열은 객체 사이에 쉼표를 N-1개 넣고 양끝에 대괄호 2개를 더합니다. NDJSON은 줄마다 줄바꿈 문자를 N개 넣습니다. 레코드가 5,000개면 줄바꿈이 한 줄씩 더 붙어, 딱 그만큼 커집니다.
그래서 용량은 사실상 동률입니다. NDJSON을 쓰는 이유는 크기가 아니라 다루는 방식에 있습니다. 이 차이는 데이터가 표처럼 평평한 객체 묶음일 때의 구조적 결과라서, 같은 종류 데이터면 방향이 거의 바뀌지 않습니다. 다만 객체 내용이 길어질수록 이 1.5% 비율은 더 작아집니다.
대용량에서 NDJSON이 빛나는 진짜 이유
일반 JSON 배열은 파싱하려면 보통 파일 전체를 한 번에 메모리로 올려야 합니다. 닫는 대괄호를 만나야 비로소 하나의 완성된 값이 되기 때문입니다. 수 기가바이트짜리 배열이면 그만큼 메모리가 필요합니다.
NDJSON은 줄 단위로 완결되니, 한 줄 읽고 처리하고 버리는 식으로 흘려보낼 수 있습니다. 아래는 위에서 만든 NDJSON을 한 줄씩만 읽어 amount 합계를 구하는 코드입니다. 전체를 통째로 메모리에 올리지 않습니다.
import json

total = 0
count = 0
with open("data.jsonl", encoding="utf-8") as f:
    for line in f:            # 한 줄씩만 읽어 처리
        rec = json.loads(line)
        total += rec["amount"]
        count += 1

print(count, "줄 처리, amount 합계 =", total)
실제 실행 결과는 5000 줄 처리, amount 합계 = 124158809이었습니다. 같은 일을 배열로 하려면 json.load(f)로 리스트 전체를 먼저 올려야 합니다.
한 줄 이어붙이기(append)도 간단합니다
로그처럼 데이터가 계속 쌓이는 상황에서, 배열은 새 레코드를 넣으려면 닫는 대괄호를 떼고 쉼표를 붙인 뒤 다시 닫아야 합니다. NDJSON은 파일 끝에 줄 하나만 더하면 끝입니다.
import json

new = {"user_id": 5001, "name": "신규", "event": "login", "amount": 100}
with open("data.jsonl", "a", encoding="utf-8") as f:   # "a"는 이어쓰기
    f.write(json.dumps(new, ensure_ascii=False) + "\n")
실행하니 줄 수가 5,000에서 5,001로 늘었습니다. 로그 수집, 스트리밍 데이터, 한 건씩 추가되는 기록에 NDJSON이 널리 쓰이는 이유가 여기 있습니다.
직접 만들어 확인하고 싶다면
아래 코드를 그대로 실행하면 같은 데이터를 배열과 NDJSON으로 저장하고 두 파일 크기를 출력합니다. 파이썬만 깔려 있으면 추가로 받을 패키지는 없습니다.
import os, json, random
random.seed(7)
s = ["김","이","박","최","정"]
g = ["민수","서연","지훈","하은","도윤"]
e = ["login","logout","click","purchase","view"]

rows = [{"user_id": i,
         "name": random.choice(s) + random.choice(g),
         "event": random.choice(e),
         "amount": random.randint(0, 50000)} for i in range(1, 5001)]

with open("data.json", "w", encoding="utf-8") as f:
    json.dump(rows, f, ensure_ascii=False, separators=(",", ":"))

with open("data.jsonl", "w", encoding="utf-8") as f:
    for r in rows:
        f.write(json.dumps(r, ensure_ascii=False, separators=(",", ":")) + "\n")

for name in ["data.json", "data.jsonl"]:
    print(name, os.path.getsize(name), "bytes")
seed를 7로 고정했으므로 같은 환경이면 거의 같은 크기가 나옵니다. 한글이 섞이면 UTF-8 기준 바이트 수가 달라질 수 있어, 위 측정은 모두 UTF-8 기준입니다.
자주 묻는 질문
Q. .jsonl 파일을 일반 JSON 도구로 열면 오류가 나요.
파일 전체를 하나의 JSON으로 읽으려 해서 그렇습니다. NDJSON은 줄 단위로 읽어야 합니다. 줄을 돌며 각각 파싱하면 정상 처리됩니다.
Q. .jsonl과 .ndjson 중 어느 확장자가 맞나요?
둘 다 같은 형식을 가리킵니다. 도구나 서비스에 따라 표기가 다를 뿐 내용 규칙은 동일합니다.
Q. 이미 가진 배열 JSON을 NDJSON으로 바꿀 수 있나요?
배열을 읽어 객체마다 한 줄씩 다시 쓰면 됩니다. 위 저장 코드의 NDJSON 부분이 그 변환과 같은 동작입니다.
한 번에 다 읽어 다루는 데이터면 배열 JSON, 계속 쌓이거나 너무 커서 한 줄씩 흘려보내야 하는 데이터면 NDJSON을 고르세요.
이 줄 단위 발상은 데이터 분석에서 자주 만나는 Parquet나 로그 처리용 형식으로도 이어집니다. 큰 데이터를 통째로 들지 않고 잘라서 다루는 방식이 왜 유리한지 궁금하다면 그쪽 형식도 같은 관점으로 살펴보면 이해가 빠릅니다.
줄 단위로 쌓는 형식은 압축과 잘 어울립니다. 저장 모양에 따른 용량 차이는 한 줄과 들여쓰기를 비교한 글에, 압축한 채로 바로 읽는 방법은 gzip 으로 다룬 글에 정리돼 있습니다.
'데이터' 카테고리의 다른 글
| 앱이 만든 .db 파일, 안에 든 데이터를 들여다보는 단계별 방법 (0) | 2026.07.11 |
|---|---|
| Parquet 파일 받았는데 더블클릭해도 안 열립니다, 파이썬과 비전공자용 방법까지 (0) | 2026.07.09 |
| 받은 JSON을 엑셀로 봐야 할 때, XLSX로 변환하는 가장 깔끔한 방법 (0) | 2026.07.06 |
| JSON "Expecting property name", "Expecting ',' delimiter" 오류, 증상별로 원인 찾고 고치기 (0) | 2026.07.05 |
| CSV를 Parquet로 변환하기, 특별한 프로그램 없이 pandas 한 줄이면 됩니다 (1) | 2026.07.04 |


