받은 엑셀 파일을 열었더니 날짜 칸에 2026-10-16 대신 46311 같은 다섯 자리 숫자가 들어 있는 경우가 있습니다. CSV로 내보낸 파일이나 프로그램으로 읽어 온 표에서도 자주 보입니다. 날짜가 깨진 것처럼 보이지만 데이터는 멀쩡합니다.
엑셀은 날짜를 처음부터 숫자로 저장합니다. 우리가 보던 '2026-10-16'은 그 숫자 위에 씌운 표시 형식이었고, 형식이 벗겨지면 원래 숫자가 드러납니다. 서식만 날짜로 바꾸면 대부분 바로 돌아옵니다. 다만 1900년 초의 날짜와 맥에서 만든 오래된 파일은 하루 또는 4년씩 어긋날 수 있어서, 그 부분은 따로 확인해야 합니다.
이 글의 숫자는 openpyxl로 날짜를 넣은 xlsx를 직접 만들고, 파일 안에 실제로 저장된 값을 열어 확인한 결과입니다. 측정 환경은 Ubuntu 24.04, 파이썬 3.13.16, openpyxl 3.1.5, pandas 3.0.5, 리브레오피스 24.2입니다.
46311은 '1900년 1월 1일부터 센 날짜 수'입니다
xlsx 파일은 압축 파일이라 풀어서 시트 XML을 열어 볼 수 있습니다. 날짜 여섯 개를 넣은 셀에는 이런 값이 들어 있었습니다.
| 화면에 보이는 날짜 | 파일 안에 저장된 값 |
| 1900-01-01 | 1 |
| 1900-02-28 | 59 |
| 1900-03-01 | 61 |
| 2000-01-01 | 36526 |
| 2026-10-16 | 46311 |
| 2026-10-16 14:30 | 46311.60416666666 |
정수 부분은 날짜, 소수 부분은 하루 중 시각입니다. 0.6041666…은 14시간 30분을 24시간으로 나눈 값입니다. 그래서 날짜끼리 빼면 바로 며칠 차이인지가 나오고, 엑셀이 날짜 계산을 쉽게 하는 이유도 여기에 있습니다.
그런데 표를 보면 이상한 점이 하나 있습니다. 2월 28일이 59인데 3월 1일은 60이 아니라 61입니다. 60번은 어디로 갔을까요.
60번은 존재하지 않는 1900년 2월 29일입니다
1900년은 윤년이 아닙니다. 그런데 엑셀은 1900년을 윤년으로 계산해 2월 29일에 60번을 배정합니다. 초창기 스프레드시트였던 로터스 1-2-3과 날짜 숫자를 맞추려고 일부러 남겨 둔 동작이고, Microsoft도 공식 문서에서 이 사실을 밝히고 있습니다.
문제는 다른 프로그램이 이 가짜 하루를 따라 하지 않는다는 점입니다. 같은 숫자를 리브레오피스와 파이썬 pandas로 날짜로 바꿔 보니, 1900년 3월 1일 이전에서만 하루씩 어긋났습니다.
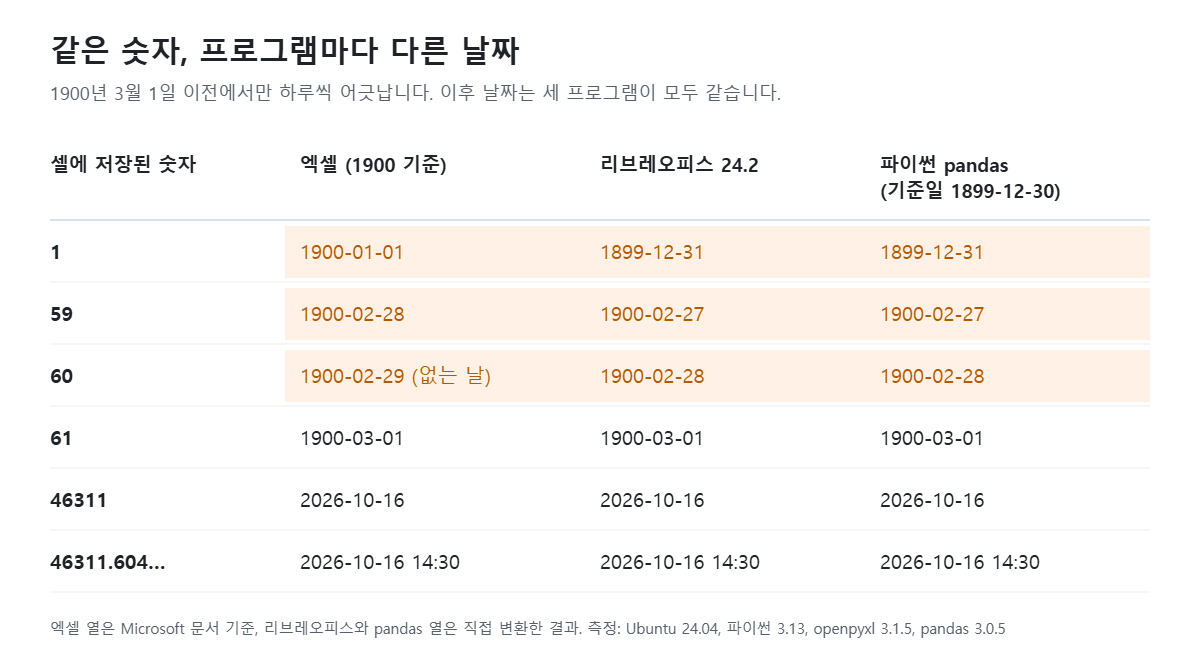
리브레오피스로 xlsx를 CSV로 내보내면 1900-01-01로 넣은 날짜가 1899-12-31로 적혀 나왔습니다. 1900년 1~2월 날짜를 다룰 일은 드물지만, 생년월일이나 역사 자료처럼 오래된 날짜가 들어간 표를 다른 프로그램으로 옮길 때는 이 하루를 의심해 봐야 합니다.
맥에서 만든 파일은 4년 하고 하루가 어긋날 수 있습니다
엑셀에는 기준일이 하나 더 있습니다. 예전 맥용 엑셀이 쓰던 '1904 날짜 체계'로, 1904년 1월 1일을 0으로 셉니다. 같은 날짜를 1904 체계로 저장한 파일을 만들어 보니 2026-10-16이 46311이 아니라 44849로 들어 있었습니다. 차이는 정확히 1,462일, 4년 하고 하루입니다.
이 설정은 파일 안 workbook.xml에 date1904라는 표시로 남습니다. 1904 체계 파일의 셀을 1900 체계 파일로 값만 복사해 붙이면 날짜가 4년 하루 앞당겨져 보이는 것이 이 때문입니다. 1904 체계에서는 1904년 이전 날짜가 음수가 되어, 1900-01-01은 -1460으로 저장됐습니다.
날짜가 숫자로 보이게 되는 경우
같은 날짜를 한 열에는 날짜 서식으로, 다른 열에는 '일반' 서식으로 넣고 여러 방법으로 읽어 보았습니다.
| 읽는 방법 | 날짜 서식 열 | 일반 서식 열 |
| pandas read_excel | 날짜(Timestamp) | 46311.0 |
| openpyxl | 날짜(datetime) | 46311 |
| 리브레오피스에서 CSV로 저장 | 2026-10-16 00:00:00 | 46311 |
파일 안의 값은 두 열이 똑같습니다. 날짜로 읽히느냐 숫자로 읽히느냐는 오로지 셀 서식이 날짜인지에 달려 있습니다. 실무에서 서식이 벗겨지는 흔한 경우는 이렇습니다.
- 날짜 셀을 복사해 '값만 붙여넣기'로 일반 서식 칸에 붙였을 때
- 다른 프로그램이 xlsx를 만들면서 날짜 서식을 지정하지 않았을 때
- 서식이 일반인 열을 CSV로 내보냈을 때. 이때는 숫자 그대로 글자로 저장됩니다.
숫자를 다시 날짜로 되돌리는 법
엑셀에서는 해당 열을 선택하고 셀 서식에서 '날짜'를 고르면 끝입니다. 값은 손대지 않고 보이는 방식만 바꾸는 것이라 되돌려도 안전합니다.
파이썬에서 바꿀 때는 기준일을 1899-12-30으로 잡아야 합니다. 1900-01-01이 1번이니 1899-12-31이 맞을 것 같지만, 엑셀의 가짜 2월 29일 때문에 3월 이후 날짜가 모두 하루 밀립니다. 실제로 기준일을 1899-12-31로 두고 바꿔 보니 46311이 2026-10-17로 나왔습니다.
import pandas as pd

s = pd.Series([46311, 46311.6041666667])
d = pd.to_datetime(s, unit="D", origin="1899-12-30")
print(d.dt.round("s"))
# 0   2026-10-16 00:00:00
# 1   2026-10-16 14:30:00
마지막 줄의 반올림은 넣어 두는 편이 좋습니다. 반올림 없이 바꿨더니 14:30이 '14:30:00.000002931'처럼 몇 마이크로초 어긋났습니다. 소수로 저장된 시각을 다시 계산하면서 생기는 오차라, 초 단위로 반올림하면 사라집니다.
맥에서 만든 1904 체계 파일이라면 기준일을 1904-01-01로 바꿔 주면 됩니다. 어느 체계인지 모르겠다면, 결과 날짜가 정확히 4년 하루씩 어긋나 있는지 한두 개만 맞춰 보면 바로 알 수 있습니다.
이 방법으로 안 되는 경우
서식을 날짜로 바꿨는데도 그대로라면 그 칸에 든 것이 숫자가 아니라 글자일 가능성이 큽니다. 셀이 왼쪽 정렬돼 있거나 앞에 작은따옴표가 붙어 있으면 글자입니다. 이 경우는 날짜 문제가 아니라 숫자처럼 보이는 텍스트 문제라서, 합계가 0으로 나오는 현상과 원인이 같습니다.
함께 읽으면 좋은 글
'데이터' 카테고리의 다른 글
| 기록을 지웠는데 db 파일 크기가 1바이트도 안 줄었습니다 (0) | 2026.09.27 |
|---|---|
| JSON 파일이 커서 안 열릴 때, 통째로 읽지 않고 훑어보는 법 (0) | 2026.09.26 |
| 엑셀에서 CSV를 열었더니 한글이 깨졌습니다, 원인과 해결법 (0) | 2026.09.25 |
| CSV를 열었더니 모든 값이 A열 한 칸에 몰려 있을 때 (0) | 2026.09.25 |
| 행이 100만 개를 넘는 CSV는 엑셀 시트 한 장에 다 안 들어갑니다 (0) | 2026.09.23 |


