API에서 받은 JSON이 20메가바이트를 넘습니다. 메모장은 응답이 없고, 편집기는 열다가 멈추고, 파이썬으로 읽으면 컴퓨터가 한참 버벅입니다.
파일이 무거운 것보다 읽는 방식이 메모리를 몇 배로 부풀리는 것이 문제입니다. 23.5메가바이트짜리 JSON을 세 가지 방법으로 읽으면서 메모리와 시간을 직접 재 봤습니다.
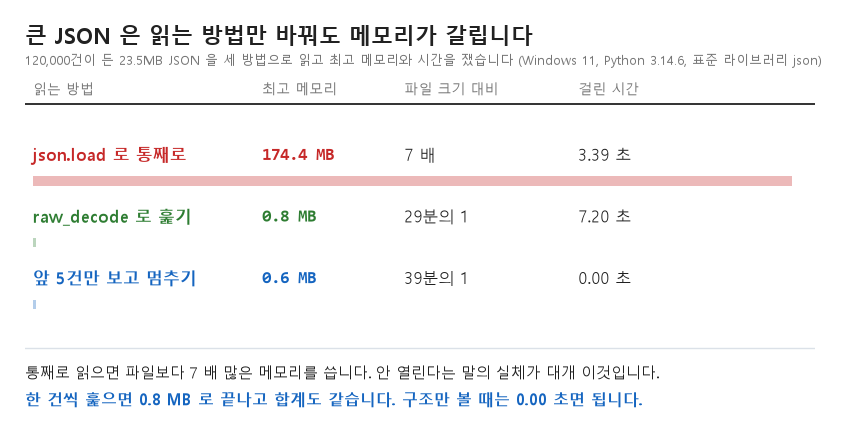
파일은 23메가인데 메모리는 174메가였습니다
주문 내역 12만 건을 담은 24,639,898바이트 파일을 만들었습니다. 한 건마다 고객 정보와 품목 배열이 중첩으로 들어 있는, 흔한 모양입니다.
| 읽는 방법 | 최고 메모리 | 파일 크기 대비 | 걸린 시간 |
|---|---|---|---|
| 통째로 읽기 | 174.4 MB | 7배 | 3.39 초 |
| 한 건씩 훑기 | 0.8 MB | 29분의 1 | 7.20 초 |
| 앞 5건만 보고 멈추기 | 0.6 MB | 39분의 1 | 0.00 초 |
통째로 읽으면 파일보다 7배 많은 메모리를 씁니다. JSON의 글자를 파이썬 객체로 바꾸면서 딕셔너리와 문자열이 각각 자리를 차지하기 때문입니다. 안 열린다는 말의 실체는 대개 이것입니다. 파일이 200메가였다면 1.4기가가 필요했을 것입니다.
한 건씩 꺼내며 훑으면 0.8메가바이트로 끝납니다. 그리고 두 방법이 계산한 금액 합계는 22,076,782,000으로 같았습니다. 덜 읽은 것이 아니라 쌓아 두지 않았을 뿐입니다.
시간은 오히려 조금 더 걸립니다
솔직하게 적으면 훑기가 느립니다. 3.39초와 7.20초, 두 배 넘게 차이 났습니다. 통째로 읽는 쪽은 C로 짠 해석기가 한 번에 처리하는 반면, 훑기는 한 건마다 파이썬 코드가 개입하기 때문입니다.
그래서 선택 기준은 속도가 아닙니다. 메모리가 감당되면 통째로 읽는 편이 빠르고, 감당이 안 되면 훑기 말고는 방법이 없습니다. 애초에 못 여는 파일에서 몇 초는 문제가 되지 않습니다.
어떻게 생긴 파일인지부터 보기
손대기 전에 구조를 봐야 방법이 정해집니다. 앞의 몇 건만 꺼내는 데는 시간이 거의 들지 않았습니다. 아래는 배열 안의 객체를 하나씩 꺼내는 코드이고, 파이썬만 있으면 그대로 돌아갑니다.
import json

def walk(path, limit=None):
    dec = json.JSONDecoder()
    with open(path, encoding="utf-8") as f:
        f.read(1)                    # 여는 대괄호를 지난다
        buf, n = "", 0
        while True:
            chunk = f.read(65536)
            if not chunk:
                return
            buf += chunk
            while True:
                s = buf.lstrip(" \n\r\t,")
                if not s or s[0] == "]":
                    buf = ""
                    break
                try:
                    rec, end = dec.raw_decode(s)
                except ValueError:
                    buf = s          # 아직 한 건이 다 안 들어왔다
                    break
                yield rec
                buf, n = s[end:], n + 1
                if limit and n >= limit:
                    return

# 구조만 보기
for rec in walk("orders.json", limit=3):
    print(json.dumps(rec, ensure_ascii=False, indent=1))

# 전체를 훑으며 합계만 내기
print(sum(r["amount"] for r in walk("orders.json")))
핵심은 raw_decode입니다. 문자열 앞쪽에서 온전한 값 하나만 읽고 어디서 끝났는지를 함께 돌려줍니다. 그래서 뒤가 아직 안 왔어도 앞에서부터 처리할 수 있습니다.
중간에 끊긴 파일이라도 ValueError가 날 때까지 읽은 만큼은 건집니다. 통째로 읽는 방식은 한 글자만 어긋나도 전부 실패합니다.
애초에 이 고생을 안 하는 형식
한 줄에 한 건씩 담는 형식으로 받으면 위 코드도 필요 없습니다. for line in f: 한 줄이면 됩니다. 확장자가 .jsonl인 파일이 그것이고, 정체와 일반 JSON과의 차이는 JSON Lines를 다룬 글에 정리해 두었습니다.
보관과 전송이 목적이라면 저장 모양을 바꾸는 것만으로도 크기가 줄어듭니다. 들여쓰기를 넣고 빼는 차이는 두 방식을 저장해 잰 글에 있고, 받은 자료를 표로 봐야 한다면 중첩 구조를 CSV로 펼치는 글 쪽이 이어집니다.
큰 JSON을 받으면 열어 보려 하기 전에 앞의 세 건만 꺼내 구조부터 확인해 보세요. 무엇이 들어 있는지 알고 나면 통째로 읽을 필요가 없는 경우가 대부분입니다.
위 메모리와 시간은 윈도우 11에서 파이썬 3.14.6의 표준 라이브러리로 측정했고, 메모리는 tracemalloc이 보고한 최고치입니다. 값의 종류와 중첩 깊이에 따라 배수는 달라집니다.
'파일 형식 백과사전' 카테고리의 다른 글
| PDF를 돌려서 저장했는데 인쇄하면 다시 누워 나오는 이유 (0) | 2026.09.26 |
|---|---|
| PDF로 바꿔 보내면 이름은 안 따라갈까, 문서 정보를 직접 열어 확인했습니다 (1) | 2026.09.26 |
| 사진을 열었다 저장할 때마다 나빠진다는 말, 어디까지 사실일까 (0) | 2026.09.25 |
| 엑셀에서 CSV를 열었더니 한글이 깨졌습니다, 원인과 해결법 (0) | 2026.09.25 |
| CSV를 열었더니 모든 값이 A열 한 칸에 몰려 있을 때 (0) | 2026.09.25 |


