JPG는 열었다 저장할 때마다 화질이 조금씩 깎인다는 이야기를 자주 듣습니다. 그래서 사진을 함부로 다시 저장하면 안 된다는 말도 따라옵니다.
절반만 맞습니다. 같은 사진을 30번 열었다 저장하며 원본과 얼마나 달라지는지 픽셀 단위로 재 봤더니, 어느 지점부터는 더 이상 나빠지지 않았습니다. 대신 진짜로 계속 나빠지는 조건이 따로 있었습니다.
30번 저장해 봤습니다
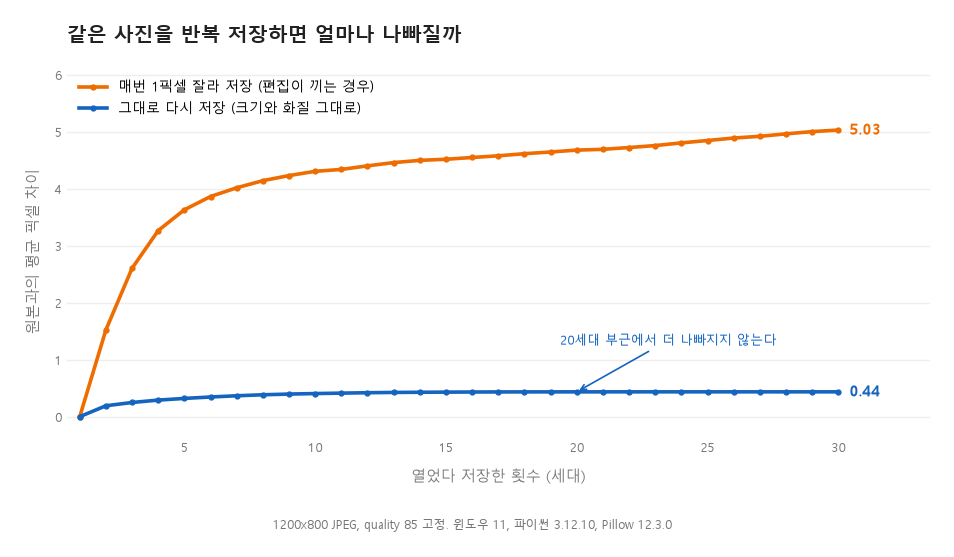
1200x800 사진을 화질 85로 저장해 원본으로 삼고, 두 갈래로 각각 30세대까지 반복했습니다. 한쪽은 크기와 화질을 그대로 두고 저장만 반복했고, 다른 쪽은 매번 1픽셀을 잘라 낸 뒤 원래 크기로 되돌려 저장했습니다. 사진을 조금이라도 손대는 상황을 흉내 낸 것입니다.
측정 환경은 윈도우 11, 파이썬 3.12.10, Pillow 12.3.0, numpy 2.5.1입니다.
파란 선이 그대로 저장한 쪽입니다. 2세대에서 평균 차이 0.19가 생기고, 10세대에 0.41, 20세대에 0.43까지 오른 뒤 거기서 멈춥니다. 30세대까지 가도 0.44입니다. 256단계 중 0.44면 눈으로 알아보기 어려운 수준입니다.
멈추는 이유가 있습니다. JPG는 사진을 8x8 칸으로 나눠 각 칸을 정해진 규칙으로 요약해 저장합니다. 한 번 요약을 거친 값을 같은 규칙으로 다시 요약하면 대개 같은 값이 나옵니다. 몇 세대 만에 더 깎일 것이 없는 상태에 도달합니다.
진짜 문제는 저장이 아니라 편집입니다
주황색 선을 보면 이야기가 달라집니다. 매번 1픽셀만 잘라 냈을 뿐인데 2세대에 벌써 평균 차이 1.52가 나고, 30세대에는 5.03까지 올라갑니다. 그대로 저장한 쪽의 11배가 넘고, 무엇보다 멈추지 않고 계속 커집니다.
1픽셀을 자르면 8x8 칸의 경계가 어긋나기 때문입니다. 앞 세대에서 자리 잡은 요약 결과가 새 경계와 맞지 않으니 매번 새로 깎입니다. 자르기뿐 아니라 크기 조정, 회전, 밝기 보정도 같은 일을 합니다.
용량도 갈렸습니다. 그대로 저장한 쪽은 30세대까지 47KB 근처를 유지했지만, 잘라 저장한 쪽은 54KB로 오히려 늘었습니다. 반복 편집으로 생긴 자잘한 얼룩이 압축을 방해하기 때문입니다. 화질은 나빠지는데 파일은 무거워지는 셈입니다.
메신저로 사진을 주고받을 때 화질이 눈에 띄게 나빠지는 것도 이 때문입니다. 보낼 때마다 크기가 조정되면서 매번 새로 깎입니다. 저장을 반복해서가 아니라 손이 갈 때마다 나빠집니다.
그래서 어떻게 다루면 될까
편집을 여러 번 할 것 같으면 중간 작업은 손실이 없는 형식으로 두고 마지막에 한 번만 JPG로 내보내는 것이 정석입니다. PNG나 편집 프로그램의 자체 형식이 여기 해당합니다. 중간 단계마다 JPG로 저장하면 그 횟수만큼 깎입니다.
이미 JPG밖에 없다면 원본을 따로 보관해 두고 사본으로 작업하세요. 한 번 깎인 화질은 되돌릴 방법이 없습니다.
반대로 겁낼 필요가 없는 경우도 분명히 해 두겠습니다. 사진을 열어 보기만 하고 닫는 것은 아무 영향이 없습니다. 파일을 복사하거나 다른 폴더로 옮기는 것도 마찬가지입니다. 다시 저장하는 순간에만 압축이 다시 일어납니다.
화질을 정하는 값 자체가 궁금하다면 JPG 저장할 때 화질을 몇으로 두면 좋을지 옵션별로 잰 글이 있습니다. 한 번 저장할 때의 이야기라 이 글과 짝이 됩니다. 손실 없이 용량만 줄이고 싶다면 PNG를 무손실 WebP로 바꾸는 쪽도 함께 보시면 좋습니다.
가진 사진으로 직접 재 보기
말보다 숫자가 확실합니다. 아래 코드는 사진 한 장을 정해진 횟수만큼 다시 저장하면서, 세대마다 원본과 얼마나 달라졌는지 출력합니다. Pillow와 numpy가 있으면 그대로 돌아갑니다.
import os, shutil, tempfile
import numpy as np
from PIL import Image

SRC = r"C:\사진\원본.jpg"
GENS = 30
QUALITY = 85

work = tempfile.mkdtemp()
cur = os.path.join(work, "gen01.jpg")
shutil.copy(SRC, cur)
base = np.asarray(Image.open(cur).convert("RGB"), dtype=np.int16)

for gen in range(2, GENS + 1):
    img = Image.open(cur).convert("RGB")
    cur = os.path.join(work, f"gen{gen:02d}.jpg")
    img.save(cur, "JPEG", quality=QUALITY)          # 여기만 반복
    now = np.asarray(Image.open(cur).convert("RGB"), dtype=np.int16)
    diff = np.abs(now - base)
    print(f"{gen:3}세대  {os.path.getsize(cur):8,}바이트  "
          f"평균차 {diff.mean():.2f}  최대차 {int(diff.max())}")
평균 차이가 몇 세대 만에 제자리에 머무르는 것을 직접 보실 수 있습니다. img.save 앞에 크기 조정이나 자르기 한 줄을 넣어 다시 돌리면, 같은 사진인데도 숫자가 계속 오르는 것으로 바뀝니다. 차이를 만드는 것이 저장이 아니라 편집이라는 점이 그 자리에서 드러납니다.
사진을 여러 번 손볼 계획이라면 작업 중에는 PNG로 두고, 다 끝난 뒤 마지막에 한 번만 JPG로 내보내세요. 저장 횟수보다 편집 횟수가 화질을 가릅니다.
'파일 형식 백과사전' 카테고리의 다른 글
| PDF로 바꿔 보내면 이름은 안 따라갈까, 문서 정보를 직접 열어 확인했습니다 (1) | 2026.09.26 |
|---|---|
| JSON 파일이 커서 안 열릴 때, 통째로 읽지 않고 훑어보는 법 (0) | 2026.09.26 |
| 엑셀에서 CSV를 열었더니 한글이 깨졌습니다, 원인과 해결법 (0) | 2026.09.25 |
| CSV를 열었더니 모든 값이 A열 한 칸에 몰려 있을 때 (0) | 2026.09.25 |
| 화면 캡처 PNG가 유독 무거울 때, 색 수를 줄여 절반으로 (0) | 2026.09.24 |


