관공서나 은행에서 받은 PDF를 열었는데 글자를 드래그하면 잡히지 않고, Ctrl+F로 아는 단어를 검색해도 아무것도 안 나오는 경우가 있습니다. 화면에는 글자가 멀쩡히 보이는데 말입니다.
고장이 아닙니다. 그 PDF 안에는 애초에 글자가 들어 있지 않습니다. 종이를 스캔해 사진으로 넣은 문서라서 그렇습니다. 같은 내용을 두 방식으로 만들어 안을 열어 보면 차이가 분명해집니다.
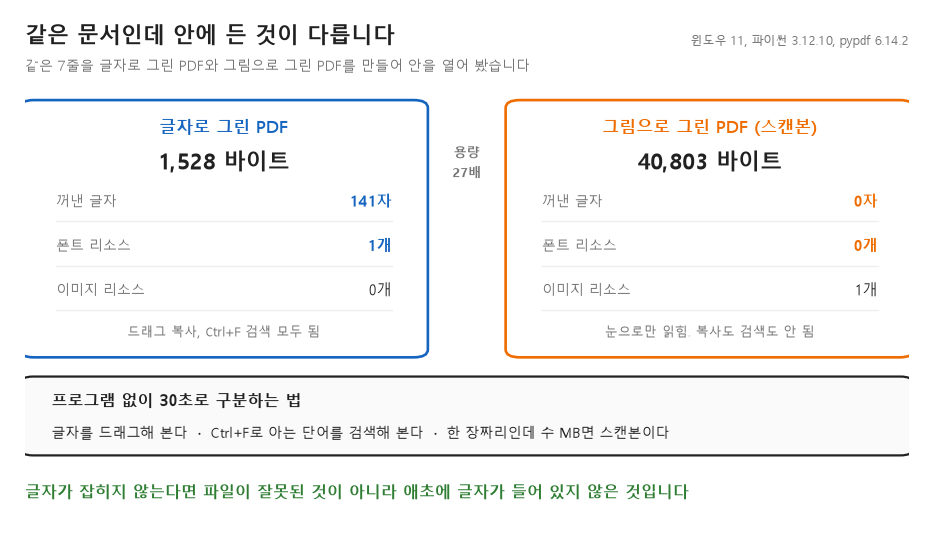
안에 든 것이 다릅니다
같은 7줄짜리 문서를 두 번 만들었습니다. 하나는 글자를 그려 넣었고, 하나는 같은 내용을 그림으로 그린 뒤 PDF로 저장했습니다. 스캔본과 같은 구조입니다. 측정 환경은 윈도우 11, 파이썬 3.12.10, pypdf 6.14.2입니다.
세 가지가 갈립니다.
첫째, 꺼낼 수 있는 글자. 글자로 그린 쪽은 141자가 그대로 나왔고, 그림으로 그린 쪽은 0자였습니다. 빈 문자열입니다. 드래그가 안 되는 이유가 이것입니다.
둘째, 폰트 리소스. 글자를 화면에 그리려면 어떤 글꼴로 그릴지 정보가 있어야 합니다. 글자로 그린 PDF에는 폰트가 1개 들어 있고, 스캔본에는 0개입니다. 글자가 없으니 글꼴도 필요 없습니다.
셋째, 용량. 1,528바이트와 40,803바이트로 27배 차이가 났습니다. 글자는 몇 바이트면 담기지만 그림은 픽셀을 전부 담아야 하기 때문입니다.
스캔 PDF의 용량이 잘 줄지 않는 것도 같은 이유입니다. PDF 용량 줄이기를 눌러도 안 줄어드는 경우를 따로 다뤘는데, 그쪽과 이 글은 같은 파일의 앞뒷면입니다. 안에 든 것이 그림이라 무겁고, 그림이라 복사가 안 됩니다.
프로그램 없이 30초로 구분하기
코드를 돌리지 않아도 구분할 수 있습니다. 위에서 아래로 순서대로 해 보시면 됩니다.
1. 글자를 드래그해 봅니다. 파란 선택 영역이 글자 모양대로 잡히면 텍스트 PDF입니다. 사각형으로 뭉텅이째 잡히거나 아무것도 안 잡히면 그림입니다.
2. Ctrl+F로 아는 단어를 검색합니다. 화면에 분명히 보이는 단어인데 검색 결과가 0건이면 그 단어는 글자가 아니라 그림의 일부입니다.
3. 용량을 봅니다. 한두 장짜리 문서인데 수 MB라면 스캔본일 가능성이 높습니다. 글자만 든 문서는 장당 수십 KB를 넘기기 어렵습니다.
확실히 하고 싶다면 파일 안을 직접 세어 볼 수도 있습니다. 폰트가 0개면 글자가 없는 문서입니다.
from pypdf import PdfReader

reader = PdfReader("받은문서.pdf")
for i, page in enumerate(reader.pages, 1):
    text = (page.extract_text() or "").strip()
    res = page.get("/Resources")
    res = res.get_object() if hasattr(res, "get_object") else (res or {})
    fonts = res.get("/Font")
    print(f"{i}쪽  글자 {len(text)}자  폰트 {len(fonts.get_object()) if fonts else 0}개")
글자로 바꿔야 한다면
스캔본에서 글자를 꺼내려면 그림을 읽어 글자로 옮기는 문자 인식(OCR)을 거쳐야 합니다. 무료로 쓸 수 있는 방법이 몇 가지 있습니다.
구글 드라이브에 PDF를 올린 뒤 구글 문서로 열면 인식된 글자가 함께 나옵니다. 윈도우와 맥의 기본 사진 앱에도 화면 속 글자를 선택하는 기능이 들어 있어, 한두 쪽이라면 그것으로 충분합니다. PDF 편집 프로그램에도 대개 OCR 기능이 있습니다.
다만 인식은 완벽하지 않습니다. 손글씨, 흐린 스캔, 표 안의 숫자는 자주 틀립니다. 인식 결과를 그대로 믿지 말고 원본과 대조하세요. 특히 금액이나 날짜는 한 글자만 틀려도 뜻이 달라집니다.
반대로 글자가 남아 있어서 곤란한 경우도 있습니다. 검은 사각형으로 가린 글자가 그대로 복사되는 문제가 그렇습니다. 지금 문제와 정확히 뒤집힌 상황입니다.
받은 PDF에서 아는 단어 하나를 Ctrl+F로 검색해 보세요. 0건이 나오면 그 문서는 그림입니다. 파일을 고칠 일이 아니라 인식을 거쳐야 하는 상황입니다.
'파일 형식 백과사전' 카테고리의 다른 글
| 스캔한 계약서 PDF가 너무 무거울 때, 안에 든 사진을 다시 압축해 줄이기 (1) | 2026.09.15 |
|---|---|
| 사진을 잘라냈는데 용량이 그대로이거나 오히려 커졌다면 (0) | 2026.09.14 |
| 사진 수백 장 이름을 찍은 날짜로 한 번에 바꾸기 (0) | 2026.09.13 |
| 사진 옮겼더니 찍은 날짜가 전부 오늘, 촬영일이 진짜 사라지는 지점은 따로 있습니다 (0) | 2026.09.12 |
| 비밀번호 걸린 ZIP 만드는 법, 윈도우와 맥에서 안전하게 압축하기 (0) | 2026.09.11 |


